
Schnellerer Index-Aufbau: Zwei Bits pro Dimension
The index-construction task of the SISAP 2026 Indexing Challenge scores the time to build the index as well as the time to search it. We made a single distance computation eight times smaller, which halves the build — and then spent four tenths of a second buying back the accuracy that costs. Third place out of fourteen teams.

Die SISAP Indexing Challenge ist ein offener Wettbewerb für Ähnlichkeitssuche (Similarity Search): Die Veranstalter stellen standardisierte Datensätze bereit, alle Einreichungen laufen unter identischen Bedingungen, und Rechenzeit wird erst ab einer definierten Mindestgenauigkeit gewertet. Unser Überblick zur diesjährigen Challenge Wir haben Grund zu feiern! Erster Platz in der Vektorsuche bei der SISAP 2026 Indexing Challenge deckt alle drei Aufgaben und das Gesamtfeld ab. Hier geht es um die Disziplin, bei der auch die Konstruktion des Index in die Wertung einfließt.
An den Start gingen wir mit dem „Dynamic Exploration Graph“ (DEG), dem Index hinter unserer eigenen Suchmaschine. Wir haben darüber bereits im Blog berichtet Dynamic Exploration Graph: Schnelle Suche in dynamischen Katalogen. Dort erklären wir, was ein Nachbarschaftsgraph (Proximity Graph) ist und warum unser Ansatz darauf ausgelegt ist, Einfüge- und Löschoperationen direkt im laufenden Suchbetrieb zu verarbeiten. Die quelloffene Implementierung heißt deglib, auf der beide Einreichungen aufsetzen.
Allen Aufgaben ist eines gemeinsam: Approximative Nächste-Nachbarn-Suche (Approximate Nearest Neighbor Search, ANNS) tauscht ein Quäntchen Genauigkeit gegen massive Geschwindigkeitsvorteile. Daher definiert jede Aufgabe einen Mindestwert für diese Genauigkeit und misst die Zeit erst an zweiter Stelle. Als Metrik dient der Recall: der Anteil der echten nächsten Nachbarn, die eine Suche tatsächlich aufspürt. Bei einem Recall von 0,80 sind 8 von 10 Treffern echte nächste Nachbarn. Niemand kann sich hier Rechenzeit erkaufen, indem er minderwertige Treffer liefert.
Die Challenge: Wenn der Datensatz sich selbst abfragt
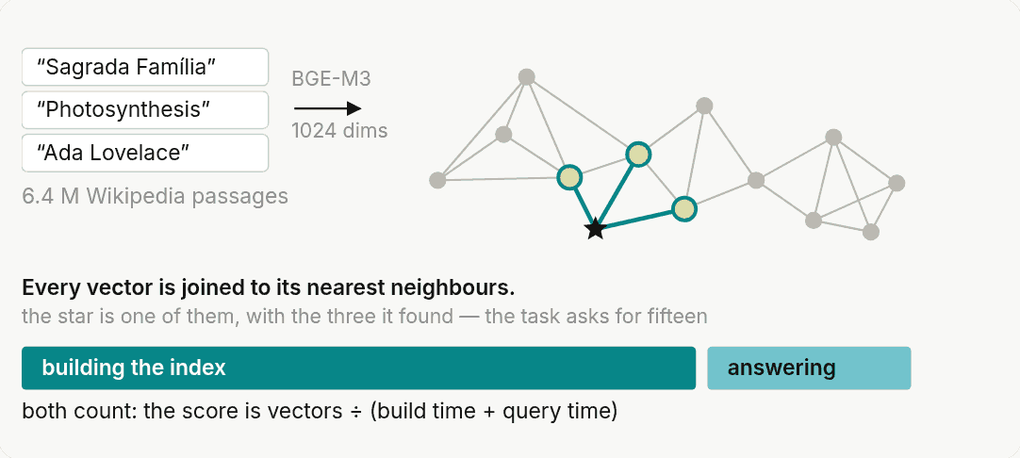
Aufgabe 1 stellt das übliche Setup auf den Kopf: 6,4 Millionen Wikipedia-Passagen werden mit BGE-M3 in 1024 normalisierte Dimensionen eingebettet. Gesucht werden die 15 nächsten Nachbarn für ausnahmslos jeden einzelnen Eintrag. Es gibt kein separates Query-Set, denn die Datenbasis fragt sich selbst ab. Da die Indexierungszeit voll in die Gesamtwertung einfließt, frisst die Konstruktionsphase den Löwenanteil der Rechenzeit.
Der Hebel: Radikale Kompression auf zwei Bits pro Dimension
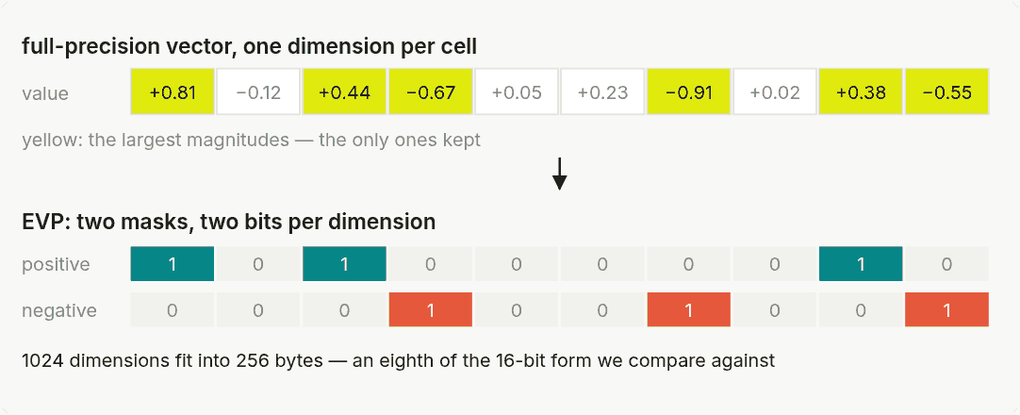
Unser Hebel: Distanzberechnungen bereits während des Graphenaufbaus drastisch verbilligen. Statt Vektoren mit voller Fließkommapräzision zu vergleichen, nutzen wir eine kompakte Zwei-Bit-Repräsentation: Von jedem Vektor behalten wir nur die Dimensionen mit den größten Beträgen – und von diesen wiederum lediglich das Vorzeichen.
Die Idee stammt nicht von uns: Equi-Voronoi-Polytope (EVP) wurden auf der SISAP 2025 von Connor, Dearle and Claydon eingeführt und damals von einem anderen Team eingesetzt. Ein Ansatz muss nicht zwingend den ersten Platz holen, um extrem nützlich zu sein. Für eine Aufgabe, die von der Aufbauzeit dominiert wird, schien EVP genau der richtige Hebel. Ob das Verfahren dem Kontakt mit unserem Graphen standhalten würde, ließ sich allerdings erst durch harte Benchmarks klären.
Der Haken: Wo Quantisierung an ihre Grenzen stößt
Der Name verrät bereits den Haken. Jeder Vektor wird durch den nächstgelegenen Knotenpunkt (Vertex) eines Polytops ersetzt, dessen Zellen die Einheitskugel der Vektoren in gleich große Areale unterteilen. Der Raum zerfällt in Zellen – und verglichen werden am Ende nur noch diese Zellen, nicht mehr die Originalvektoren. Der Query-Vektor durchläuft dieselbe Quantisierung. Zwei Vektoren in derselben Zelle erhalten denselben Code, ganz egal, wie weit sie im Originalraum voneinander entfernt lagen.
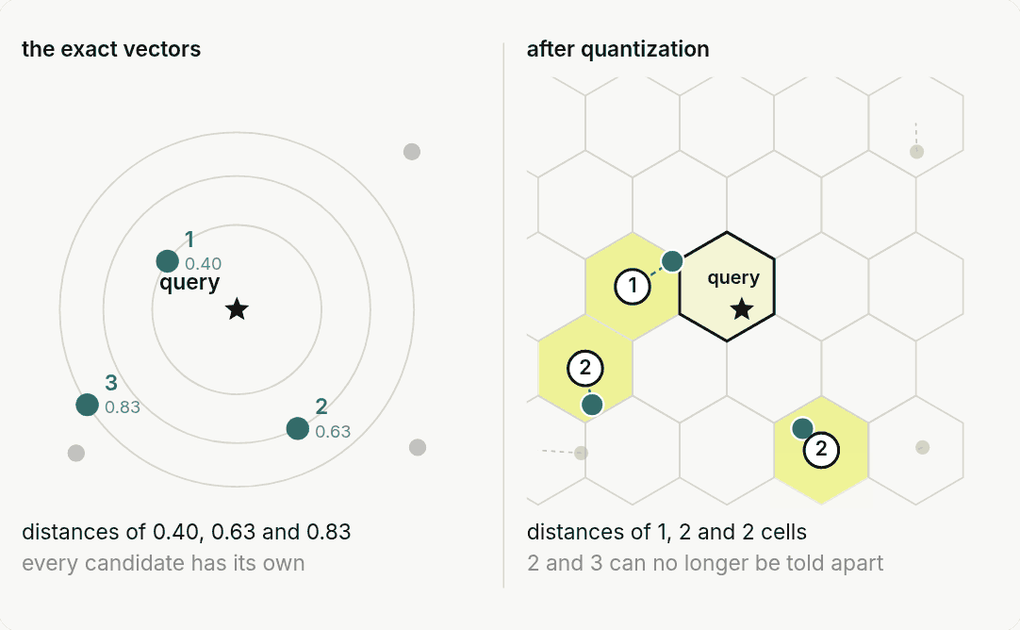
Dass diese Codes nicht das letzte Wort sein können, hat neben der Geometrie auch einen simplen arithmetischen Grund: Der Code-Vergleich ist ein bloßer Zählvorgang – man ermittelt, wie viele der signifikanten Dimensionen im Vorzeichen übereinstimmen, abzüglich der widersprüchlichen. Das Ergebnis ist stets eine ganze Zahl. Bei 1024 Dimensionen existieren folglich nur einige hundert diskrete Resultate; Vektoren mit völlig unterschiedlichen realen Distanzen landen unausweichlich auf demselben Wert.
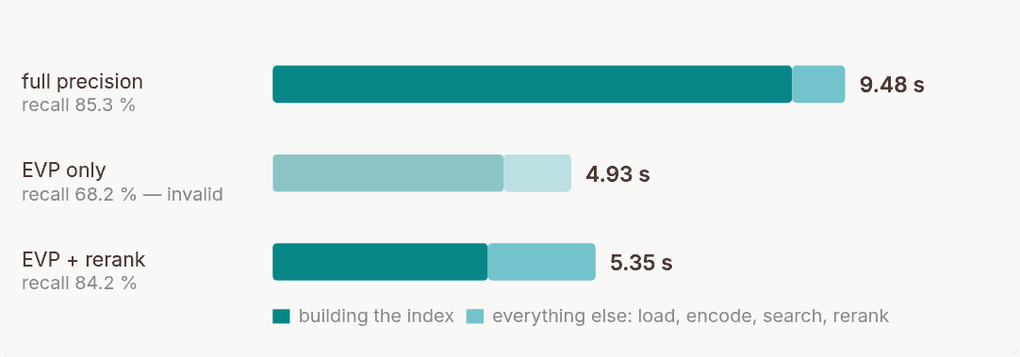
Connor, Dearle und Claydon argumentieren, dass dies genügt, um die relevanten Kandidaten vorzufiltern. Für ein verlässliches Ranking reicht es jedoch keinesfalls. Unsere Messungen bestätigten das: Isoliert betrachtet halbiert die Zwei-Bit-Form zwar die Aufbauzeit, verfehlt danach aber zu viele echte Nachbarn. Der Recall stürzt auf 68 Prozent ab – weit unter die geforderten 80 Prozent.
Die Lösung: Man behandelt die Resultate der Quantisierung nicht als Endergebnis, sondern als reine Kandidatenliste. Gesucht wird zunächst rasant auf der EVP-Repräsentation; anschließend wird diese Shortlist anhand der exakten Vektoren (16-Bit-Floats, die der Index ohnehin im Speicher hält) rekapituliert und neu sortiert (Reranking). Die grobe Form siebt vor, die präzise Form entscheidet über die Rangfolge.
Erst grob filtern, dann präzise nachschärfen
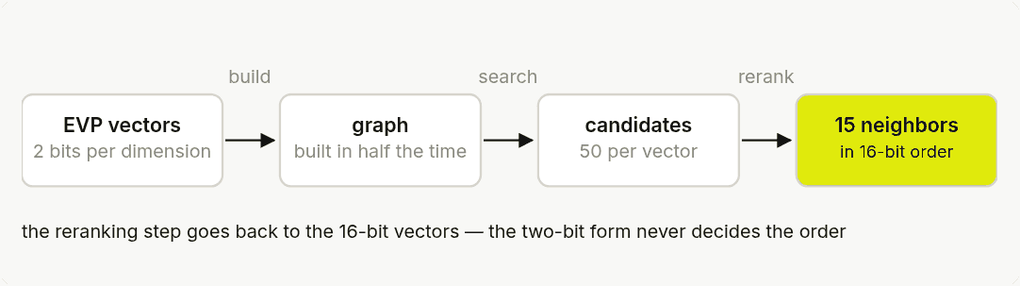
Der Preis dafür: Eine Shortlist von 50 Kandidaten pro Vektor und ein einziger Durchlauf exakter Arithmetik. Der Gewinn: Man holt sich exakt den Recall zurück, den die Quantisierung gekostet hat.
Auf einem Subset von 200.000 Vektoren (wo ein Durchlauf mit voller Präzision die Recall-Hürde problemlos nimmt und als Referenz dient) lässt sich das Trade-off direkt ablesen: Die Aufbauzeit halbiert sich, während das Reranking gerade einmal vier Zehntelsekunden beansprucht.
Platz 3 und wie die Konkurrenz gewann
Das reichte souverän für Platz 3, mehr war allerdings nicht drin.
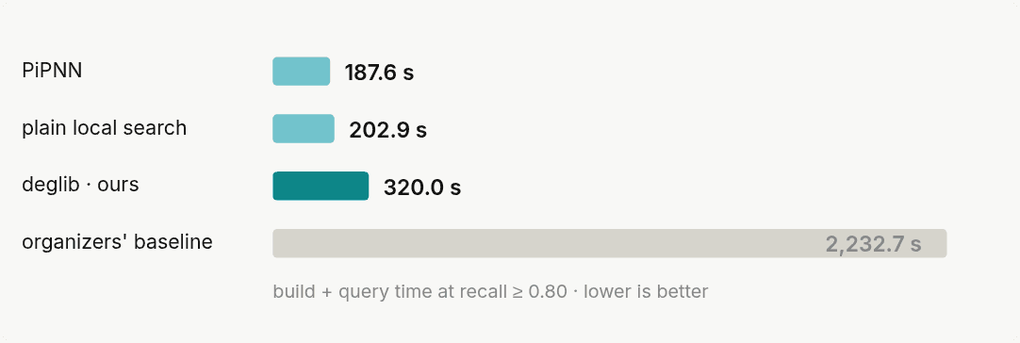
Der Siegerbeitrag, PiPNN, ist maßgeschneidert für genau diesen Aufgabentyp. Der Clou: Der Algorithmus durchsucht den Graphen beim Aufbau überhaupt nicht nach Kandidaten. Stattdessen teilt er Vektoren iterativ Gruppen um zufällige Cluster-Zentren („Leader“) zu. Diese Cluster sind klein genug, dass dichte Matrixmultiplikation (Dense Matrix Arithmetic) sämtliche Distanzen innerhalb einer Gruppe in einem einzigen Rutsch berechnen kann – und groß genug, um zu überlappen, sodass gemeinsame Vektoren die lokalen Teilgraphen verbinden. Die resultierenden Kandidatenkanten werden anschließend auf ein festes Maß pro Vektor ausgedünnt.
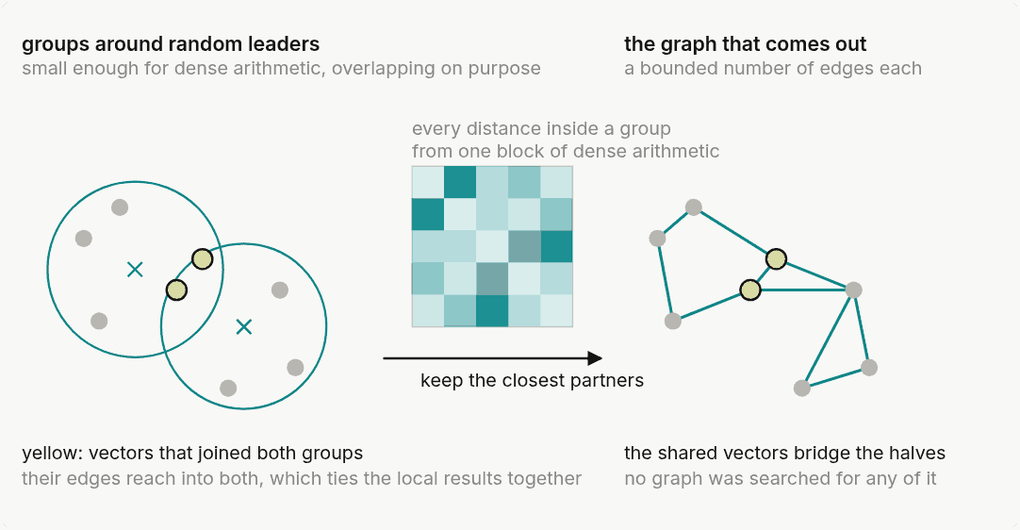
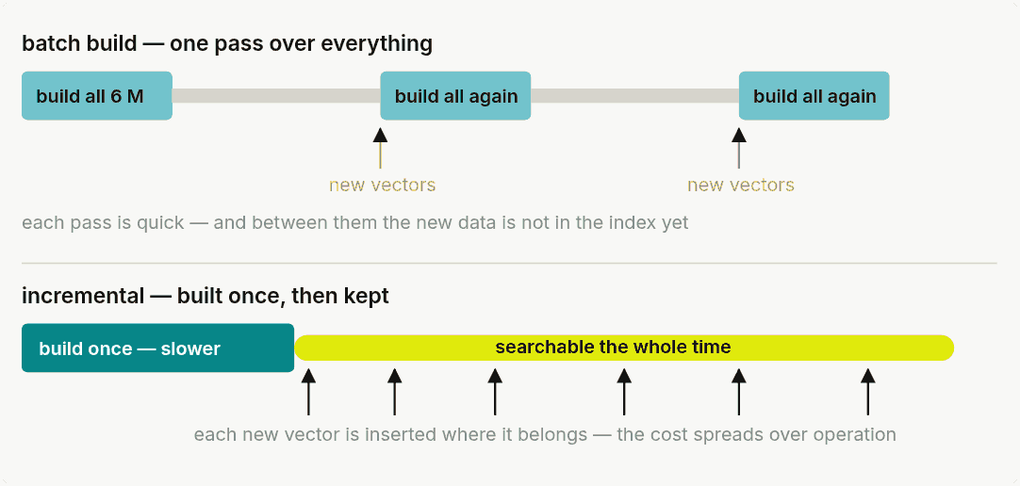
Der Geschwindigkeitsvorteil liegt hier nicht in ausgefeilteren Kriterien für Kanten, sondern in der Datenzufuhr: Die Heuristik wird mit Blöcken dichter Matrixrechnung gefüttert statt mit Traversierungen im Graphen. Das funktioniert allerdings ausschließlich deshalb, weil der Gesamtdatensatz von der ersten Sekunde an vollständig vorliegt. Einen inkrementellen Modus gibt es schlicht nicht.
Das ist die nüchterne Erklärung für den Abstand – und zugleich der Grund, warum uns das Ergebnis nicht wurmt. Unser Index ist für Produktkataloge konzipiert, die sich permanent verändern. Aufgabe 1 testet einen statischen Komplettdurchlauf über unveränderliche Daten. Unsere Embedding-Pipeline in der Praxis erfordert das exakte Gegenteil: Ständig treffen neue Vektoren ein, während der Index zu jedem Zeitpunkt stabil, zusammenhängend und voll suchbar bleiben muss. Ein reiner Batch-Builder ist beim initialen Massenaufbau schneller – muss bei Aktualisierungen aber von vorn beginnen. Wir sind bei Aufgabe 1 vor allem aus Neugier angetreten, um die Grenzen unseres Ansatzes auszuloten. Der Lohn: Eine Quantisierungsmethode, die weit über diesen Benchmark hinaus echten Mehrwert stiftet.
Fazit: Schneller Index-Aufbau für lebendige Daten
Die Quantisierung ist die eigentliche Errungenschaft, die diesen Wettbewerb überdauert. Sie schrumpft jede einzelne Distanzberechnung beim Graphaufbau auf ein Achtel zusammen – und genau dieser Konstruktionsaufwand explodiert, wenn Kataloge skalieren.
Während statische Batch-Verfahren in isolierten Benchmarks glänzen, beweist unsere Architektur: Hocheffizienter Index-Aufbau und blitzschnelle Suche schließen dynamische Anpassungsfähigkeit nicht aus – genau das, was moderne, schnell wachsende E-Commerce-Kataloge im Live-Betrieb verlangen.
Die zweite Challenge-Aufgabe verlangte eine ganz andere Transformation: Derselbe Index, aber eine fremde Geometrie. Wie wir das Problem zurück in den euklidischen Raum überführt haben, erklären wir hier genauer: Sieg in der Ähnlichkeitssuche: Mit einer völlig anderen Geometrie.
Literatur und Verweise
Unsere Einreichung: Hezel, Barthel, Schilling, Schall, Moelle and Jung, Fast and Efficient Approximate Nearest Neighbor Search for High-Dimensional LLM Embeddings (arXiv:2607.20957), mit der vollständigen Methode und allen Messungen (auf Englisch).
Unser code: Visual-Computing/sisap26-deglib, the submissions for both tasks.
Über die Challenge: SISAP 2026 Indexing Challenge, Aufgaben und Datensätze sowie die Rangliste mit den Ergebnissen aller Teams (auf Englisch).
Über den Index selbst: Unser früherer Blogartikel Dynamic Exploration Graph: Fast Search in Evolving Catalogs.
Über die Konferenz: SISAP 2026, the 19th International Conference on Similarity Search and Applications, Brno, 14–16 October 2026.
Verwandte Beiträge

Sieg in der Ähnlichkeitssuche: Mit einer völlig anderen Geometrie
