
Sieg in der Ähnlichkeitssuche: Mit einer völlig anderen Geometrie
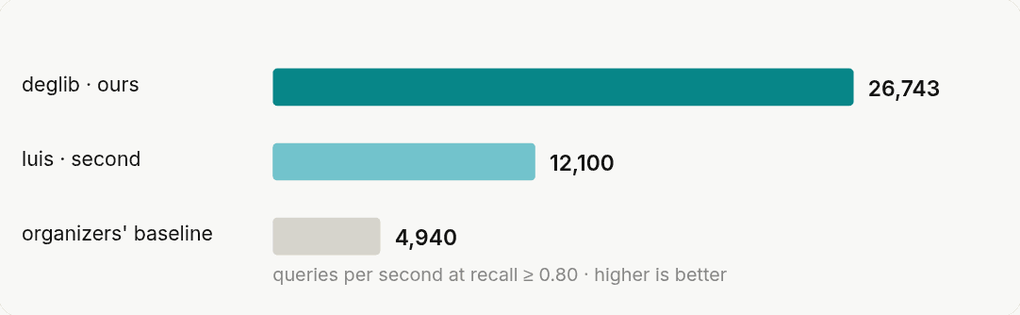
Die Such-Aufgabe der SISAP 2026 Indexing Challenge fragt nach den größten inneren Produkten – einem Ähnlichkeitsmaß, das unser Index regulär gar nicht verwendet. Indem wir die Geometrie, für die er ursprünglich entwickelt wurde, wiederherstellten und die Vektoren optimal für das Speichersystem anordneten, drückten wir die Latenz für den Query-Batch von rund 100 Millisekunden auf 29. Das Resultat: Platz 1 mit 26.743 Queries pro Sekunde.

Die SISAP Indexing Challenge ist ein offener Wettbewerb für Ähnlichkeitssuche (Similarity Search): Die Veranstalter stellen standardisierte Datensätze bereit, alle Einreichungen laufen unter identischen Bedingungen, und Rechenzeit wird erst ab einer definierten Mindestgenauigkeit gewertet. Unser Überblick zur diesjährigen Challenge deckt alle drei Aufgaben und das Gesamtfeld ab. Hier geht es um die Disziplin, die wir für uns entscheiden konnten.
An den Start gingen wir mit dem „Dynamic Exploration Graph“ (DEG), dem Index hinter unserer eigenen Suchmaschine. Wir haben darüber bereits im Blog berichtet Dynamic Exploration Graph: Schnelle Suche in dynamischen Katalogen. Dort erklären wir, was ein Nachbarschaftsgraph (Proximity Graph) ist und warum unser Ansatz darauf ausgelegt ist, Einfüge- und Löschoperationen direkt im laufenden Suchbetrieb zu verarbeiten. Die quelloffene Implementierung heißt deglib, auf der beide Einreichungen aufsetzen.
Allen Aufgaben ist eines gemeinsam: Approximative Nächste-Nachbarn-Suche (Approximate Nearest Neighbor Search, ANNS) tauscht ein Quäntchen Genauigkeit gegen massive Geschwindigkeitsvorteile. Daher definiert jede Aufgabe einen Mindestwert für diese Genauigkeit und misst die Zeit erst an zweiter Stelle. Als Metrik dient der Recall: der Anteil der echten nächsten Nachbarn, die eine Suche tatsächlich aufspürt. Bei einem Recall von 0,80 sind 8 von 10 Treffern echte nächste Nachbarn. Niemand kann sich hier Rechenzeit erkaufen, indem er minderwertige Treffer liefert.
Die Challenge: Ein fremdes Ähnlichkeitsmaß
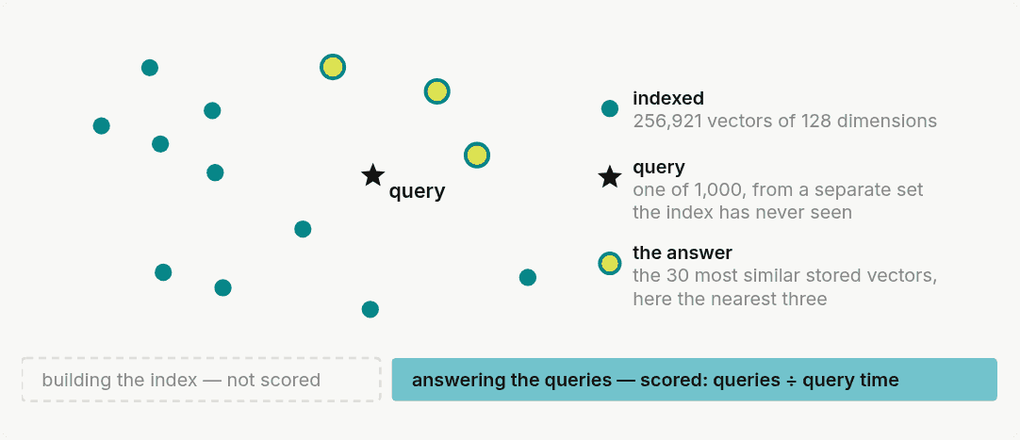
Aufgabe 2 speichert 256.921 Feature-Vektoren aus dem Inneren von Llama-3-8B in jeweils 128 Dimensionen. Für jeden Query-Vektor wird gefragt, welche 30 der gespeicherten Vektoren das größte innere Produkt (Inner Product) mit ihm aufweisen. Die Queries stammen aus einem separaten Set desselben Modells, sind aber nicht Teil der gespeicherten Kollektion. Der Index wird nur ein einziges Mal aufgebaut und beantwortet danach ausschließlich Suchanfragen, weshalb diese Task strikt die Query-Zeit bewertet.
Was die Aufgabe uns streitig macht, ist unsere eigene Definition von Ähnlichkeit. Unser Index sortiert standardmäßig nach euklidischer Distanz: Je kürzer die Linie zwischen zwei Vektoren, desto ähnlicher sind sie. Da wir unsere Embeddings auf die Länge 1 normalisieren, ist dieses Ranking exakt identisch mit der Kosinus-Ähnlichkeit (Cosine Similarity) und dem inneren Produkt – darauf sind die meisten Embedding-Modelle ohnehin trainiert. Hier sind die Vektoren jedoch nicht normalisiert, wodurch diese drei Metriken massiv voneinander abweichen.
Wie genau das aussieht, zeigt die folgende Grafik. Die Distanz lässt sich an den Ringen um den Query-Vektor ablesen: Welcher Kandidat auf dem innersten Ring sitzt, gewinnt. Die Kosinus-Ähnlichkeit ignoriert die Längen komplett und betrachtet nur den Winkel, was zum selben Siegerkandidaten führt. Das innere Produkt hingegen behält die Längen bei und misst etwas völlig anderes: wie weit ein Vektor in die exakte Richtung der Query reicht. Seine Niveaumengen sind keine Ringe um die Query, sondern Linien, die senkrecht zu ihr stehen. Ein langer Vektor, der leicht in die falsche Richtung zeigt, kann somit weiter reichen als ein kurzer, der exakt darauf ausgerichtet ist. Das Einzige, wovon diese Rangfolge nicht abhängt, ist die Länge der Query selbst: Skaliert man sie, wächst jedes innere Produkt um exakt denselben Faktor.
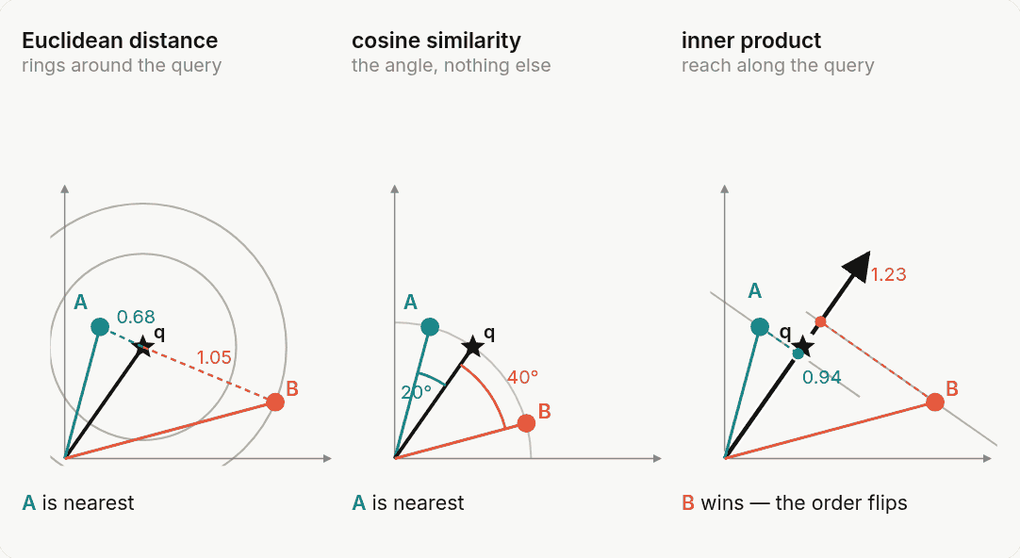
Der Startpunkt lautete also nicht: „Unser Index ist bei dieser Aufgabe langsam“, sondern: „Unser Index beantwortet eine völlig andere Frage.“ Ließe man ihn unverändert auf diesen Vektoren laufen, fände er zwar Nachbarn, die räumlich nah dran sind, aber schlichtweg nicht die, die die Task verlangt.
Der direkte Weg: Direkt nach dem inneren Produkt sortieren
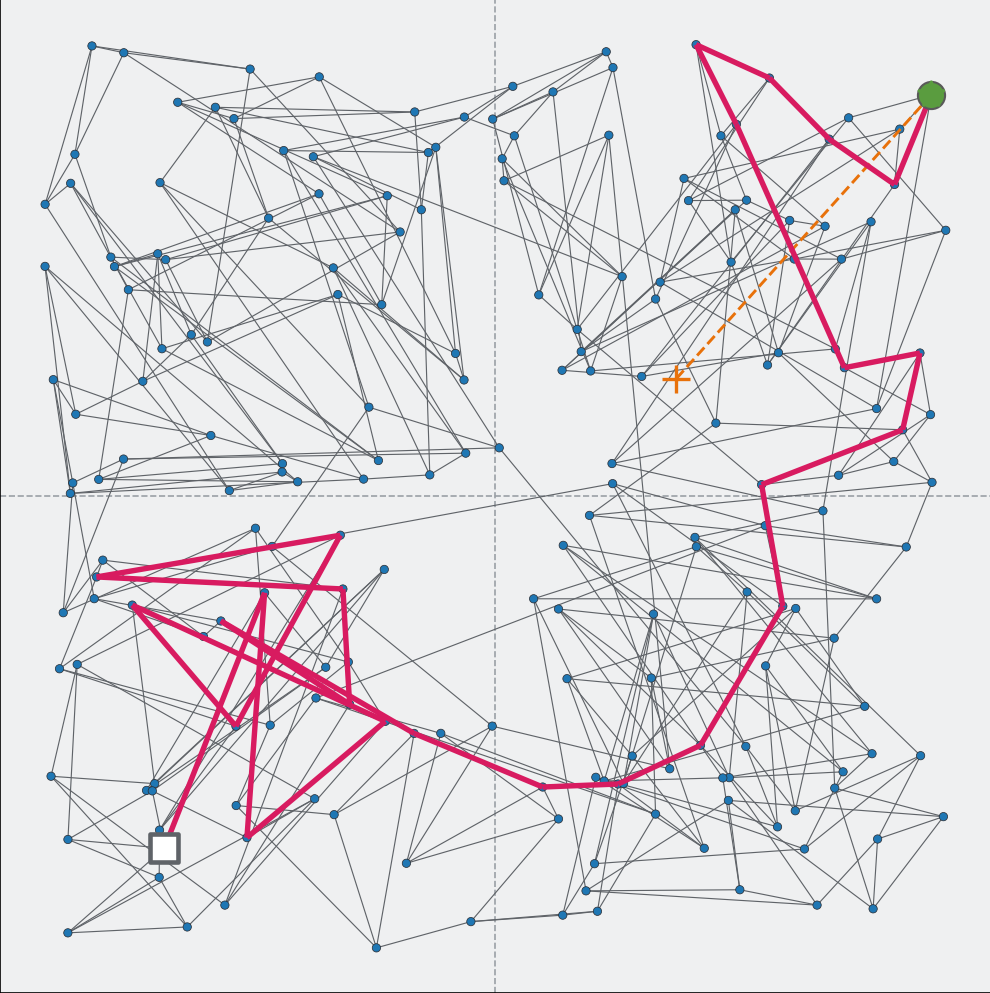
Der naheliegende Fix: Man lässt den Graphen die Kandidaten schlichtweg nach dem inneren Produkt anstatt nach Distanz sortieren. Das funktioniert – und es lohnt sich zu verstehen, warum: Der Graph verbindet nach wie vor Vektoren, die in ähnliche Richtungen zeigen. Eine Suche, die an seinen Kanten entlangwandert, landet also immer noch in der richtigen Region.
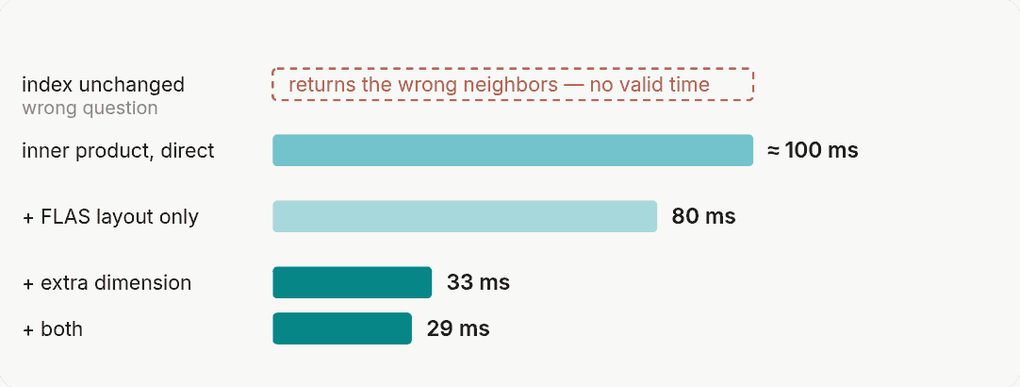
Was man dabei allerdings verliert, ist die mathematische Garantie. Ein Nachbarschaftsgraph ist aufgrund der Dreiecksungleichung navigierbar: Ein Nachbar eines Nachbarn kann niemals beliebig weit entfernt sein. Ein Greedy-Walk (Gieriger Algorithmus) verbessert sich dadurch stetig und kann frühzeitig stoppen. Das innere Produkt bietet keine solche Begrenzung. Dem Walk fehlt ein verlässliches Signal dafür, wann er fertig ist. Der einzige Ausweg, um den geforderten Recall dennoch zu erreichen: Man muss den Algorithmus wesentlich größere Teile des Graphen explorieren lassen. In unseren Parameter-Sweeps verdreifachte das das Suchbudget annähernd und trieb die Zeit für den Query-Batch auf rund 100 Millisekunden.
Der Hebel: Das Problem zurück in den euklidischen Raum holen
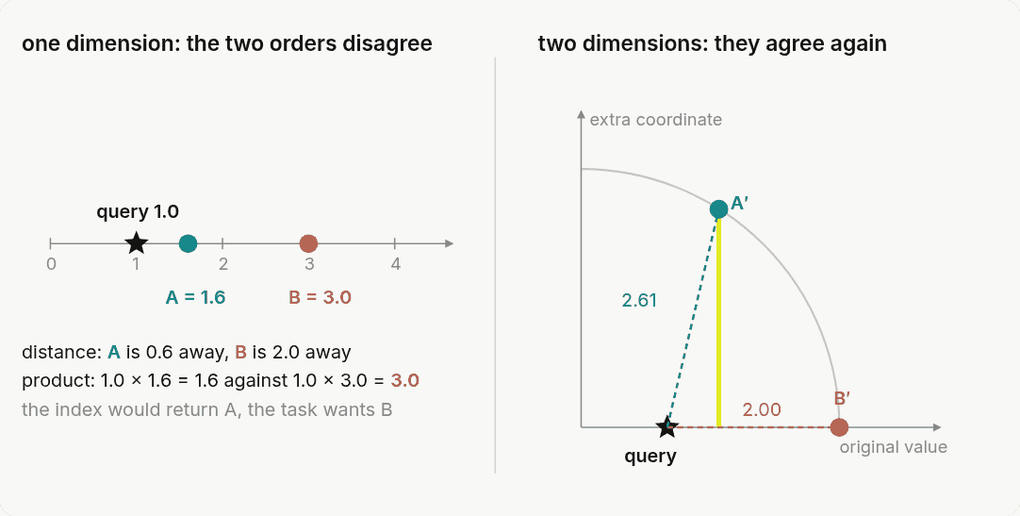
Statt die Geometrie aufzugeben, stellen wir sie einfach wieder her. Jeder gespeicherte Vektor erhält eine zusätzliche Koordinate. Diese wird so aufgefüllt, dass am Ende alle gespeicherten Vektoren exakt dieselbe Länge besitzen. Die Query erhält an dieser Stelle einfach eine Null, wodurch ihr inneres Produkt mit allen gespeicherten Vektoren absolut unverändert bleibt.
Sobald alle gespeicherten Vektoren dieselbe Länge aufweisen, ist die erweiterte Distanz zwischen einer Query und einem Vektor mathematisch nichts anderes als zwei Konstanten minus ihr inneres Produkt. Der näheste Vektor (euklidische Distanz) liefert damit automatisch auch das größte innere Produkt. Ein Index, der nach Distanz sortiert, beantwortet nun die Frage der Challenge, ohne dass man ihm das sagen müsste.
Bei den Challenge-Daten werden so aus 128 Dimensionen schlicht 129. Die Transformation ist nicht auf unserem Mist gewachsen: Sie geht zurück auf Bachrach et al. (2014) und Neyshabur und Srebro (2015). Was sie hier so mächtig machte, war die Kombination mit unserem speziell für euklidische Distanzen optimierten Graphen.
Am anschaulichsten wird das bei eindimensionalen Vektoren, wo das innere Produkt nur noch das Produkt zweier Zahlen ist und die Extradimension eine Linie in eine Ebene verwandelt.
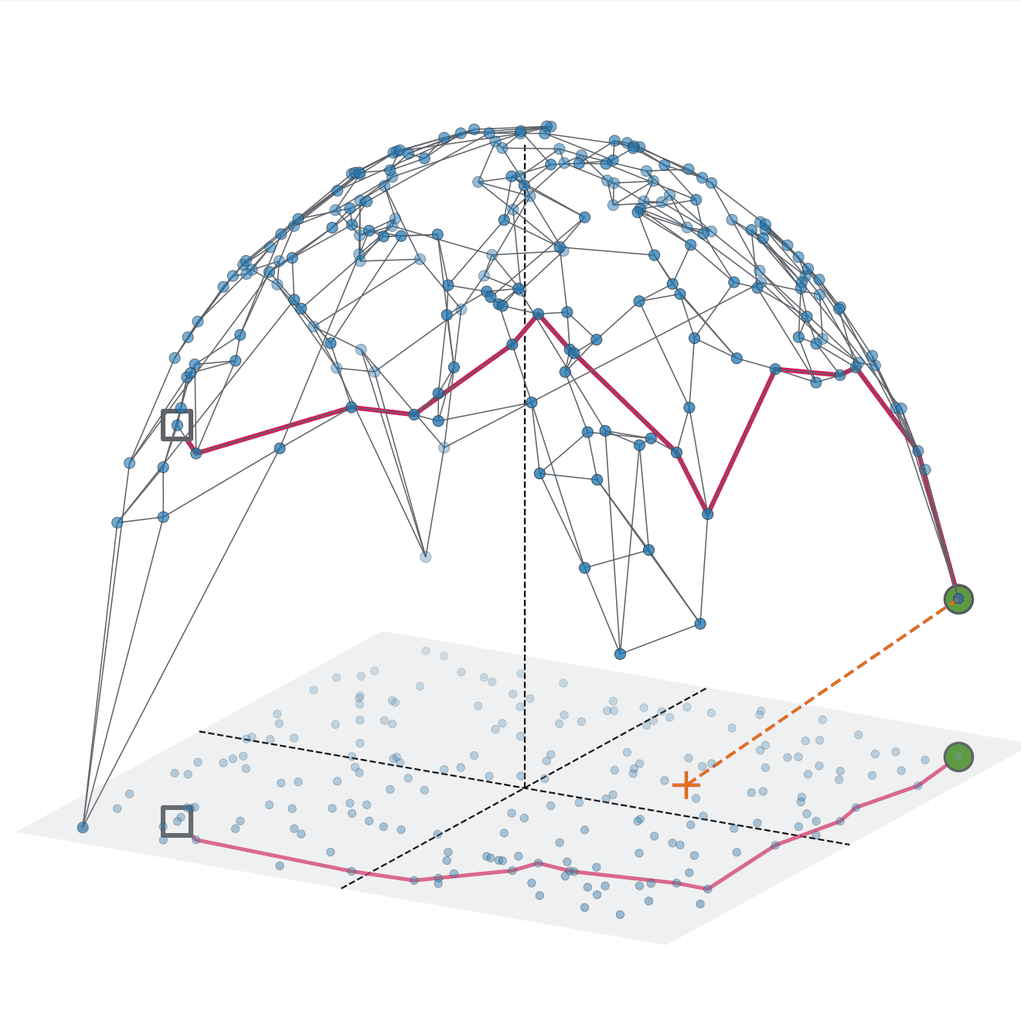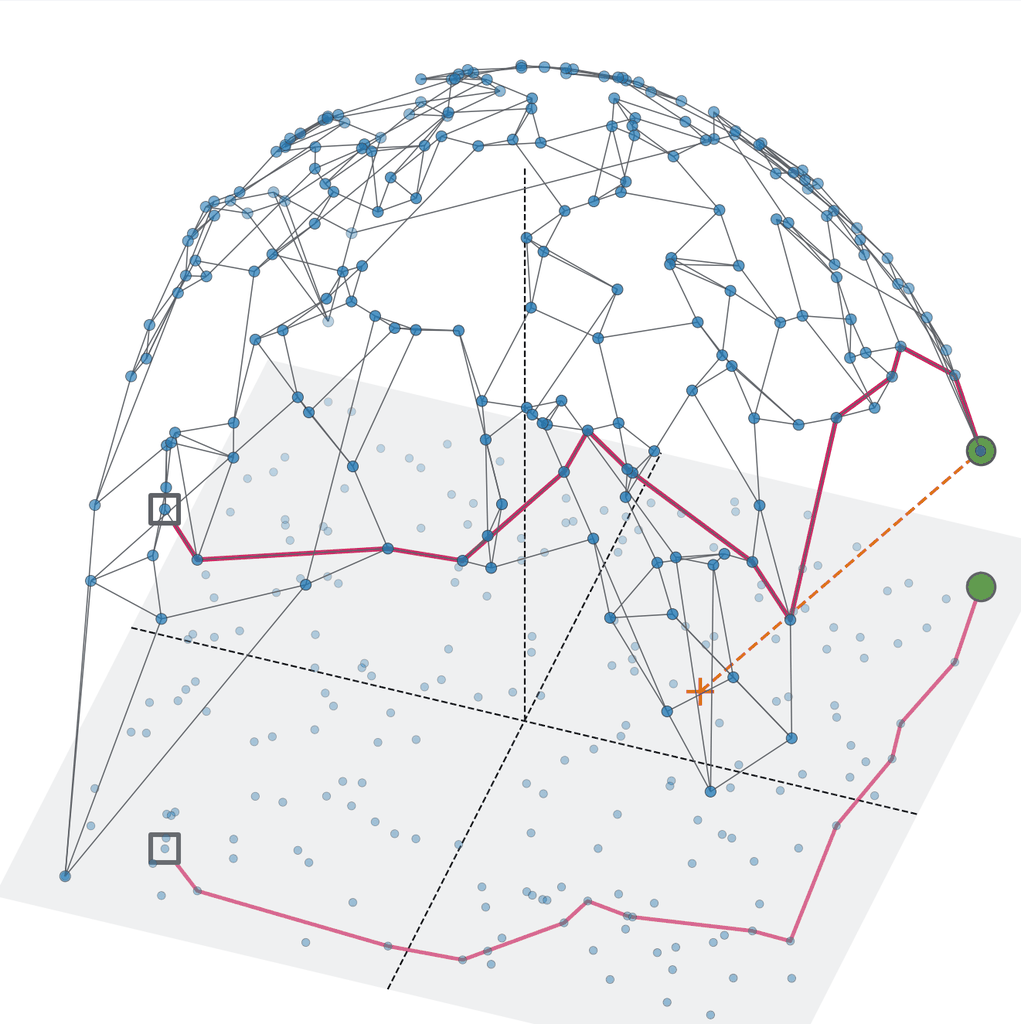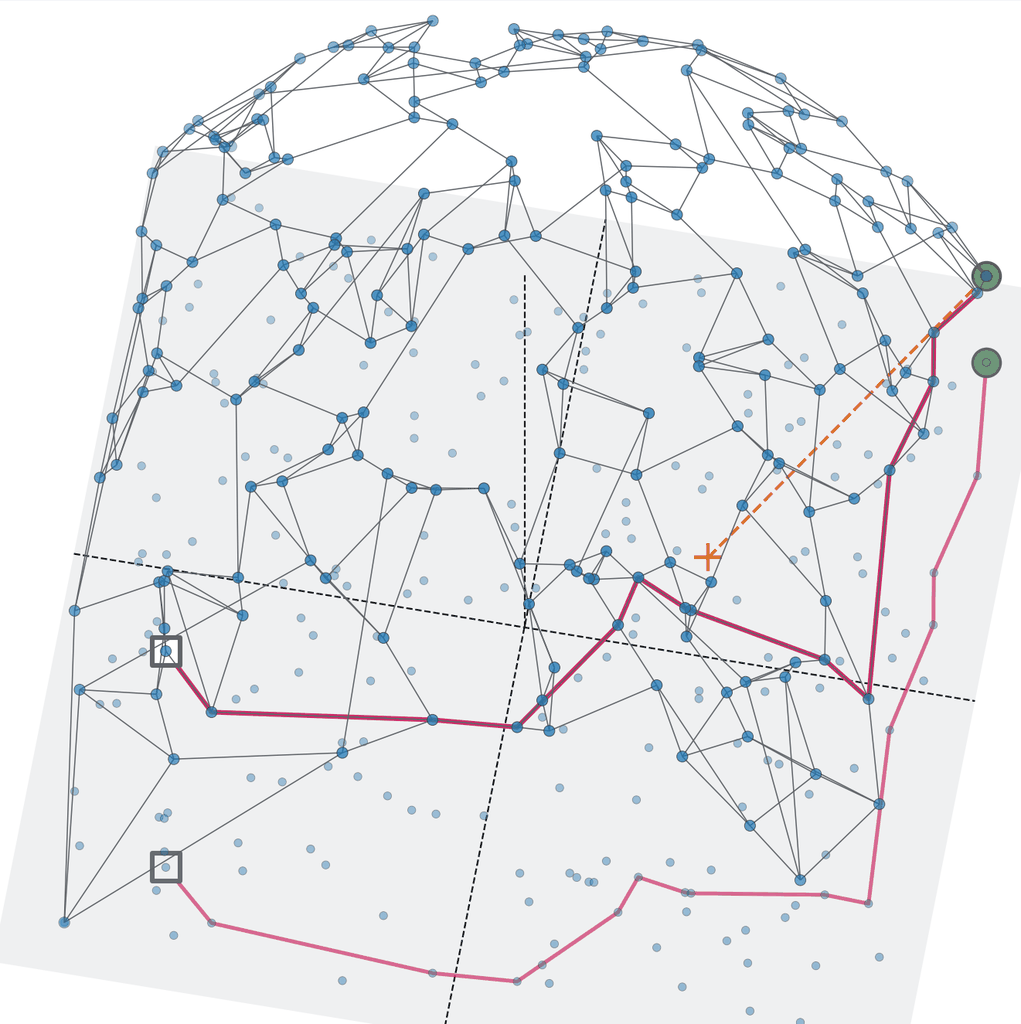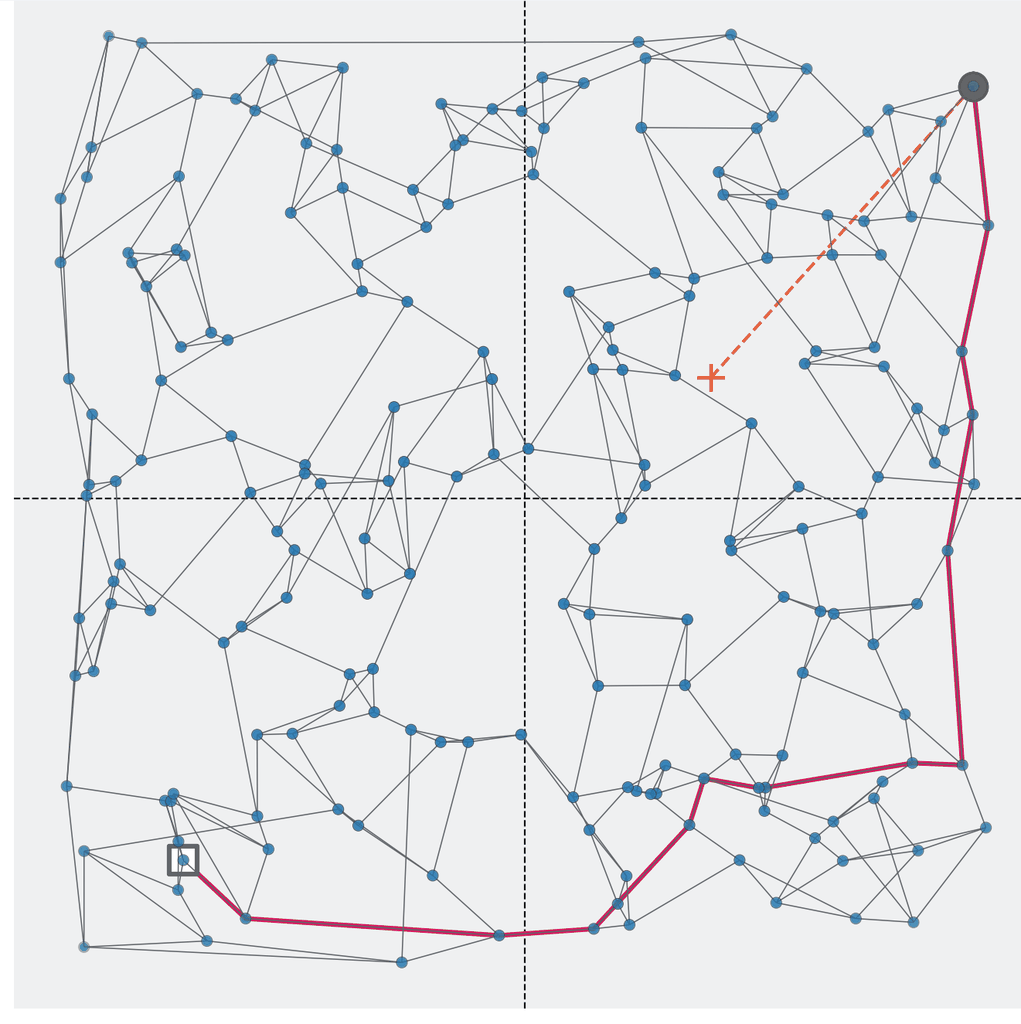
Um den Effekt zu illustrieren, wenden wir diese Technik an und fügen dem vorherigen zweidimensionalen Beispiel eine dritte Dimension hinzu: Indem wir den Graphen über diese dreidimensionalen Vektoren und mit der euklidischen Distanz konstruieren, stellen wir die Navigierbarkeit vollständig wieder her.
Das Hardware-Tuning: Vektoren fürs Speichersystem anordnen
Der restliche Performance-Sprung kam aus einer völlig anderen Richtung. Graphen-Suchen werden nicht durch Rechenleistung ausgebremst, sondern durch die Speicherbandbreite (Memory Bandwidth): Jeder Sprung (Hop) folgt Pointern zu Nachbarn, die kreuz und quer im RAM verstreut liegen können – der Prozessor wartet untätig.
Wir nutzten FLAS, eine ursprünglich für Image-Grids publizierte Sortiermethode, um die Vektoren so anzuordnen, dass sich ähnliche Vektoren vor dem Graph-Aufbau im physischen Speicher nebeneinander befinden. Ein Hop landet dadurch nun meist in Datenbereichen, die der Prozessor ohnehin bereits abgerufen (gefetcht) hat.
Die Reihenfolge beider Schritte entscheidet über den jeweiligen Gewinn: Auf der Originalgeometrie spart das Speicher-Layout allein ein Fünftel der Query-Zeit, während die Extradimension allein zwei Drittel einspart. Wendet man das Layout nach der geometrischen Transformation an, bringt es noch einmal 12 Prozent. In Kombination machten sie den gewaltigen Unterschied zwischen etwa 100 Millisekunden für den Batch und grandiosen 29 Millisekunden.
Platz 1: Das offizielle Ergebnis
Gegen die hochkarätige Konkurrenz waren es genau diese beiden Schritte, die unsere Einreichung an die Spitze katapultierten.
Fazit: Anpassung ohne Neuarchitekturg
Weder der eine noch der andere Schritt verlangte nach einem neuen Index. Die zusätzliche Koordinate ist ein reiner Preprocessing-Durchlauf über die Vektoren, das Layout eine bloße Permutation vor dem Graphaufbau. Alles, was danach passiert, ist exakt derselbe Index, den wir im operativen Betrieb ohnehin nutzen – und genau das macht beide Optimierungen direkt portierbar für Produktionssysteme.
Durch die kluge Kombination aus geometrischen Transformationen und speicheroptimierten Daten-Layouts haben wir uns nicht nur an eine neue Metrik angepasst, sondern bei der Suchgeschwindigkeit das Feld dominiert. So stellen wir sicher, dass unsere Kunden blitzschnelle Suchergebnisse erleben – selbst bei hochkomplexen Datenstrukturen.
Die andere Challenge-Aufgabe, an der wir teilgenommen haben, verlangte den exakt umgekehrten Optimierungsweg: Keine neue Geometrie, dafür drastisch verbilligte Distanzberechnungen, weil dort auch die Zeit für den Index-Aufbau in die Bewertung einfloss. Wie das über Zwei-Bit-Kompression und Reranking gelang, erklären wir in: Schnellerer Index-Aufbau: Zwei Bits pro Dimension.
Literatur und Verweise
Unsere Einreichung: Hezel, Barthel, Schilling, Schall, Moelle and Jung, Fast and Efficient Approximate Nearest Neighbor Search for High-Dimensional LLM Embeddings (arXiv:2607.20957), mit der vollständigen Methode und allen Messungen (auf Englisch).
Unser code: Visual-Computing/sisap26-deglib, the submissions for both tasks.
Über die Challenge: SISAP 2026 Indexing Challenge, Aufgaben und Datensätze sowie die Rangliste mit den Ergebnissen aller Teams (auf Englisch).
Über den Index selbst: Unser früherer Blogartikel Dynamic Exploration Graph: Fast Search in Evolving Catalogs.
Über die Konferenz: SISAP 2026, the 19th International Conference on Similarity Search and Applications, Brno, 14–16 October 2026.
Verwandte Beiträge

Schnellerer Index-Aufbau: Zwei Bits pro Dimension
